MultiHeadAttention (MHA)
原理
Query (Q)、Key (K)、Value (V)均被投影为num_heads个独立的头- 每个头维度
head_dim为hidden_size // num_heads - 每个 Query 头与对应的 Key/Value 头计算注意力
Attention,完全独立
优点
- ✅ 表达能力强,各头可学习不同语义子空间(如语法、指代、位置等)
缺点
- ❌ 内存和计算开销大:K/V 存储和计算量随
H线性增长。 - ❌ 在长序列推理时,KV Cache 占用显存极高(如 32k 上下文)
import torch
from torch import nn
import math

class MultiHeadAttention(nn.Module):
    def __init__(self, hidden_size, num_heads):
        super(MultiHeadAttention, self).__init__()
        assert hidden_size % num_heads == 0, "hidden_size must be divisible by num_heads."
        self.num_heads = num_heads
        self.head_dim = hidden_size // num_heads
        self.q_linear = nn.Linear(hidden_size, hidden_size) # IN: hidden_size, OUT: hidden_size
        self.k_linear = nn.Linear(hidden_size, hidden_size) # IN: hidden_size, OUT: hidden_size
        self.v_linear = nn.Linear(hidden_size, hidden_size) # IN: hidden_size, OUT: hidden_size
        self.o_linear = nn.Linear(hidden_size, hidden_size) # IN: hidden_size, OUT: hidden_size

    def split_heads(self, x):
        """
        Splite into MultiHead
        (batch_size, seq_len, hidden_size) → (batch_size, num_heads, seq_len, head_dim)
        """
        batch_size, seq_len, _ = x.size()
        x = x.view(batch_size, seq_len, self.num_heads, self.head_dim) # Split the last dimension (hidden_size) logically into (num_heads, head_dim) | (batch_size, seq_len, hidden_size) → (batch_size, seq_len, num_heads, head_dim)
        return x.transpose(1, 2)  # Swap the first dimension (seq_len) and the second dimension (num_heads) | (batch_size, seq_len, num_heads, head_dim) → (batch_size, num_heads, seq_len, head_dim)

    def combine_heads(self, x):
        """
        Combine MultiHead
        (batch, num_heads, seq_len, head_dim) → (batch, seq_len, hidden)
        """
        batch_size, _, seq_len, _ = x.size()
        x = x.transpose(1, 2).contiguous()  # (batch_size, num_heads, seq_len, head_dim) → (batch_size, seq_len, num_heads, head_dim)
        return x.view(batch_size, seq_len, -1)  # → (batch_size, seq_len, hidden_size)

    def forward(self, hidden_state, attention_mask=None):
        batch_size = hidden_state.size(0)

        # hidden_state: (batch_size, seq_len, hidden_size)

        # STEP 1. Linear Projection
        Q = self.q_linear(hidden_state) # (batch_size, seq_len, hidden_size)
        K = self.k_linear(hidden_state)
        V = self.v_linear(hidden_state)

        # STEP 2. Splite into MultiHead
        Q = self.split_heads(Q)  # (batch_size, num_heads, seq_len, head_dim)
        K = self.split_heads(K)
        V = self.split_heads(V)

        # STEP 3. Calculate Attention Score:QK^T / sqrt(d_k)
        # Q: (batch_size, num_heads, seq_len, head_dim)
        # K^T: (batch_size, num_heads, head_dim, seq_len)
        # matmul → (batch_size, num_heads, seq_len, seq_len)
        scale = math.sqrt(self.head_dim)
        scores = torch.matmul(Q, K.transpose(-2, -1)) / scale

        # STEP 4. Apply mask
        if attention_mask is not None:
            if attention_mask.dim() == 2:
                attention_mask = attention_mask.unsqueeze(1).unsqueeze(2) # (batch_size, seq_len) → (batch_size, 1, 1, seq_len)
            scores = scores.masked_fill(attention_mask == 1, float('-inf'))

        # STEP 5. Softmax + Weighted Sum
        attn_probs = torch.softmax(scores, dim=-1)  # (batch_size, num_heads, seq_len, seq_len)
        output = torch.matmul(attn_probs, V)        # (batch_size, num_heads, seq_len, seq_len) * (batch_size, num_heads, seq_len, head_dim) → (batch_size, num_heads, seq_len, head_dim)

        # STEP 6. Combine MultiHead
        output = self.combine_heads(output)  # (batch_size, seq_len, hidden_size)
        output = self.o_linear(output)       # MultiHead(Q, K, V) = Concat(head₁, ..., headₕ) · Wᴼ where headᵢ = Attention(QWᵢ^Q, KWᵢ^K, VWᵢ^V)

        return output
Multi-Query Attention(MQA)
原理
Query (Q)仍保留num_heads个头Key (K)、Value (V)仅使用1个头- 所有
Query (Q)头共享同一组 K/V - 利用 PyTorch 的广播机制自动对齐维度
优点
- ✅ 显著降低 KV Cache 内存:从
2 × H × L × d→2 × 1 × L × d(节省H倍) - ✅ 推理速度更快,尤其适合长文本生成
缺点
- ❌ 表达能力下降:所有 Query 头共享相同上下文表示,可能丢失细粒度信息。
- ❌ 训练时可能收敛稍慢或需要调整超参
import torch
from torch import nn
import math

class MultiQueryAttention(nn.Module):
    def __init__(self, hidden_size, num_heads):
        super(MultiQueryAttention, self).__init__()
        assert hidden_size % num_heads == 0, "hidden_size 必须能被 num_heads 整除"
        self.num_heads = num_heads
        self.head_dim = hidden_size // num_heads
        self.q_linear = nn.Linear(hidden_size, hidden_size) # IN: hidden_size, OUT: hidden_size
        self.k_linear = nn.Linear(hidden_size, self.head_dim)  # IN: hidden_size, OUT: hidden_size//num_heads
        self.v_linear = nn.Linear(hidden_size, self.head_dim)  # IN: hidden_size, OUT: hidden_size//num_heads
        self.o_linear = nn.Linear(hidden_size, hidden_size) # IN: hidden_size, OUT: hidden_size

    def _split_heads(self, x, n_heads):
        batch_size, seq_len, _ = x.size()
        x = x.view(batch_size, seq_len, n_heads, self.head_dim)
        return x.transpose(1, 2)  # (B, n_heads, L, d)

    def forward(self, hidden_state, attention_mask=None):
        batch_size = hidden_state.size(0)

        # hidden_state: (batch_size, seq_len, hidden_size)

        # STEP 1. Linear Projection
        Q = self.q_linear(hidden_state) # (batch_size, seq_len, hidden_size)
        K = self.k_linear(hidden_state) # (batch_size, seq_len, head_dim)
        V = self.v_linear(hidden_state) # (batch_size, seq_len, head_dim)
        # STEP 2. Splite into MultiHead
        Q = self._split_heads(Q, self.num_heads) # (batch_size, num_heads, seq_len, head_dim)
        K = self._split_heads(K, 1) # (batch_size, 1, seq_len, head_dim)
        V = self._split_heads(V, 1) # (batch_size, 1, seq_len, head_dim)

        # STEP 3. Calculate Attention Score:QK^T / sqrt(d_k)
        # Q: (batch_size, num_heads, seq_len, head_dim)
        # K: (batch_size, 1, seq_len, head_dim)
        # K^T: (batch_size, 1, head_dim, seq_len)
        # matmul → (batch_size, num_heads, seq_len, seq_len) ✅ 广播成功(1 → H)
        scale = math.sqrt(self.head_dim)
        scores = torch.matmul(Q, K.transpose(-2, -1)) / scale

        # STEP 4. Apply mask
        if attention_mask is not None:
            if attention_mask.dim() == 2:
                attention_mask = attention_mask.unsqueeze(1).unsqueeze(2)
            scores = scores.masked_fill(attention_mask == 1, float('-inf'))

        # STEP 5. Softmax + Weighted Sum
        attn_probs = torch.softmax(scores, dim=-1)
        output = torch.matmul(attn_probs, V) # (batch_size, num_heads, seq_len, seq_len) * (batch_size, num_heads, seq_len, head_dim) → (batch_size, num_heads, seq_len, head_dim)

        # STEP 6. Combine MultiHead
        # output: (batch_size, num_heads, seq_len, head_dim)
        # transpose → (batch_size, seq_len, num_heads, head_dim)
        # view → (batch_size, seq_len, num_heads*head_dim)
        output = output.transpose(1, 2).contiguous()
        output = output.view(batch_size, -1, self.num_heads * self.head_dim)
        output = self.o_linear(output)
        return output
Grouped-Query Attention (GQA)
原理
Query (Q)有num_heads个头Key (K)、Value (V)有group_num个头(1 < group_num < num_heads),且num_heads % group_num == 0- 每
num_heads // group_num个 Query 头共享一组 K/V
优点
- ✅ 平衡 MHA 与 MQA:在表达能力与效率之间取得折中
- ✅ 显著降低 KV Cache 内存: 减少
H / G倍(如 G=2,则减半) - ✅ 实证效果接近 MHA,远优于 MQA(Google 提出,用于 PaLM-2)
缺点
- ❌ 实现略复杂(需处理分组广播)
- ❌ 需要选择合适的
group_num(通常 2~8)
import torch
from torch import nn
import math

class GroupQueryAttention(nn.Module):
    def __init__(self, hidden_size, num_heads, group_num):
        super(GroupQueryAttention, self).__init__()
        assert num_heads % group_num == 0, "num_heads 必须能被 group_num 整除"
        self.num_heads = num_heads
        self.group_num = group_num
        self.head_dim = hidden_size // num_heads
        self.q_linear = nn.Linear(hidden_size, num_heads * self.head_dim) # IN: hidden_size, OUT: hidden_size
        self.k_linear = nn.Linear(hidden_size, group_num * self.head_dim) # IN: hidden_size, OUT: group_num * head_dim
        self.v_linear = nn.Linear(hidden_size, group_num * self.head_dim) # IN: hidden_size, OUT: group_num * head_dim
        self.o_linear = nn.Linear(num_heads * self.head_dim, hidden_size) # IN: hidden_size, OUT: hidden_size

    def _split_heads(self, x, n_heads):
        batch_size, seq_len, _ = x.size()
        x = x.view(batch_size, seq_len, n_heads, self.head_dim)
        return x.transpose(1, 2)

    def forward(self, hidden_state, attention_mask=None):
        batch_size = hidden_state.size(0)

        # STEP 1. Linear Projection
        Q = self.q_linear(hidden_state) # (batch_size, seq_len, hidden_size)
        K = self.k_linear(hidden_state) # (batch_size, seq_len, group_num * head_dim)
        V = self.v_linear(hidden_state) # (batch_size, seq_len, group_num * head_dim)

        # STEP 2. Splite into MultiHead
        Q = self._split_heads(Q, self.num_heads) # (batch_size, num_heads, seq_len, head_dim)
        K = self._split_heads(K, self.group_num) # (batch_size, group_num, seq_len, head_dim)
        V = self._split_heads(V, self.group_num) # (batch_size, group_num, seq_len, head_dim)

        # 3. ★ GQA 核心:广播 Key/Value 到每个 Query 头所属的组 ★
        # 每组有 `num_heads // group_num` 个 query 头共享同一组 K/V
        # 例如:H_q=8, H_g=2 → 每组 4 个 query 头共享 1 组 K/V
        # 方法:将 K/V 在 head 维度上 repeat,而非 reshape!
        repeat_times = self.num_heads // self.group_num
        K = K.unsqueeze(2).expand(-1, -1, repeat_times, -1, -1).reshape(
            batch_size, self.num_heads, -1, self.head_dim
        )
        V = V.unsqueeze(2).expand(-1, -1, repeat_times, -1, -1).reshape(
            batch_size, self.num_heads, -1, self.head_dim
        )

        scale = math.sqrt(self.head_dim)
        scores = torch.matmul(Q, K.transpose(-2, -1)) / scale

        # STEP 4. Apply mask
        if attention_mask is not None:
            if attention_mask.dim() == 2:
                attention_mask = attention_mask.unsqueeze(1).unsqueeze(2)
            scores = scores.masked_fill(attention_mask == 1, float('-inf'))

        # STEP 5. Softmax + Weighted Sum
        attn_probs = torch.softmax(scores, dim=-1)
        output = torch.matmul(attn_probs, V)

        # STEP 6. Combine MultiHead
        output = output.transpose(1, 2).contiguous()
        output = output.view(batch_size, -1, self.num_heads * self.head_dim)
        output = self.o_linear(output)
        return output
MHA & GQA & MQA对比
| 特性 | MHA | GQA | MQA |
|---|---|---|---|
| Key/Value 头数 | H | G(1 < G < H) | 1 |
| Query 头数 | H | H | H |
| KV Cache 内存 | 2 × H × L × d | 2 × G × L × d | 2 × L × d |
| 表达能力 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐ |
| 推理速度 | 慢 | 中 | 快 |
| 训练稳定性 | 高 | 高 | 中(可能需调参) |
| 典型应用 | BERT, ViT | PaLM-2, Mixtral | StarCoder, T5, LLaMA(部分) |
Multi-Head Latent Attention (MLA)
缓存:阴影圆圈
缓存:绿色带宽字体

- :模型隐藏层维度(hidden size)
- :注意力头数(number of heads)
- :每个注意力头的维度
- :KV 压缩潜在向量维度(如 512)
- :Q 压缩潜在向量维度(如 1536)
- :RoPE 分量的 head 维度(如 64)
1. KV 压缩与重建
输入 token 表示
KV 压缩 (共享)
KV 重建
2. RoPE 分量
RoPE Key (共享)(MQA 风格)
Q 的 RoPE 分量(per-head)
先压缩 Q:
再生成 RoPE Q:
可 reshape 为:
3. Q/K/V 构造
Query
先重建 Q 的内容部分:
拼接 RoPE:
Key
Value
4. Attention 计算
Score
Attention
输出
5. 多头合并
Matrix Absorption矩阵吸收
在计算 时:
点积为:
其中:
- 是固定参数,可预计算
→ 推理时无需重建 ,只需缓存
同理, 可被吸收到 中,避免显式缓存
| 缓存项 | 维度 | 说明 |
|---|---|---|
| 低秩潜在向量(如 512) | ||
| RoPE Key(MQA,如 56) |
Native Sparse Attention (NSA)
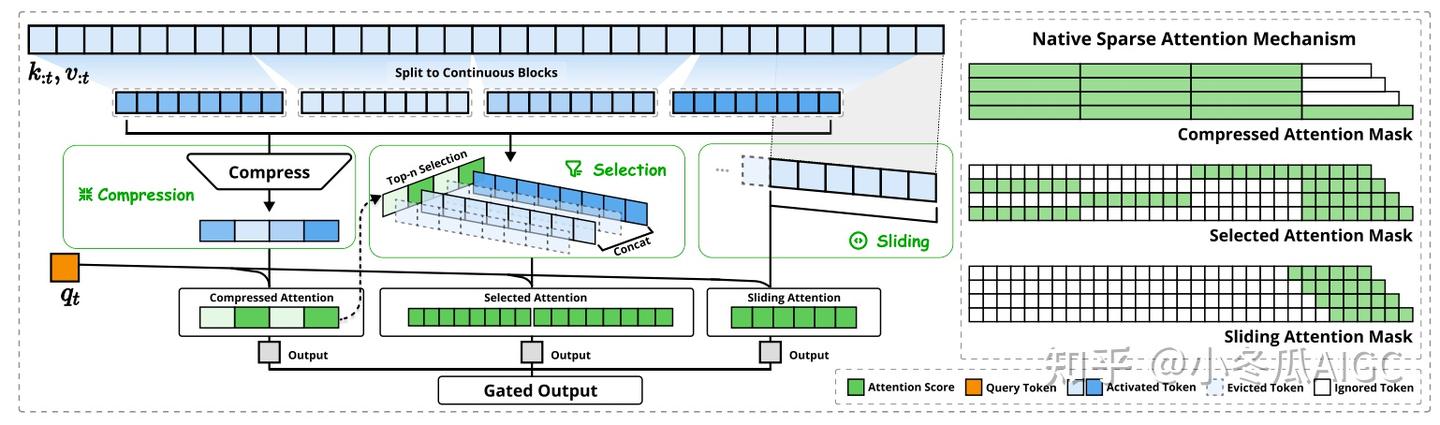
一句话概括 NSA
NSA = 先压缩看全局 → 再精选看局部 → 加滑窗保邻近 → 门控融合三路输出。从训练开始就学稀疏,比事后剪枝靠谱得多。
三支注意力详解
总览图
输入序列 x₁, x₂, ..., x_T
         │
         ↓
   线性投影 → Q, K, V
         │
    ┌────┼────────────┐
    ↓    ↓            ↓
  压缩   选择        滑窗
  注意力  注意力      注意力
    │    ↑            │
    │    │            │
    │  压缩分数       │
    │  ─→ top-k选块   │
    │    │            │
    ↓    ↓            ↓
  o_cmp  o_slc      o_win    三者维度相同!
    │    │            │
    └────┼────────────┘
         │
    门控聚合: g_cmp·o_cmp + g_slc·o_slc + g_win·o_win
         │
         ↓
      最终输出 o*
1. 🔵 压缩注意力(Compression Attention)
目的:快速扫描全文,找出"大概哪些段落重要"
做法:把一段 KV 压缩成一个 KV
原始 KV 序列(32个):
[k₁,k₂,k₃,k₄,k₅,k₆,k₇,k₈ | k₉,...,k₁₆ | k₁₇,...,k₂₄ | k₂₅,...,k₃₂]
          块1                  块2           块3           块4

压缩后(4个):
[k̃₁, k̃₂, k̃₃, k̃₄]
  ↑     ↑     ↑     ↑
 块1   块2   块3   块4 的"代表"
怎么压缩? 用一个 MLP(小神经网络):
8 个 K 压缩成 1 个 K̃:
K̃₁ = MLP(k₁, k₂, k₃, k₄, k₅, k₆, k₇, k₈)
这就像把一段话的 8 句话总结成 1 句——丢失了细节,但保留了全局大意。
然后 Q 只和 4 个压缩 K 算注意力:
Q₃₂ · K̃₁ = 0.5   ← 块1不太重要
Q₃₂ · K̃₂ = 2.8   ← 块2很重要!★
Q₃₂ · K̃₃ = 0.3   ← 块3不重要
Q₃₂ · K̃₄ = 3.1   ← 块4很重要!★
压缩注意力的输出:融合了 4 个块的全局信息(粗糙,但全面)
2. 🟢 选择注意力(Selection Attention)
目的:对压缩注意力发现的"重要块",精细地读
做法:根据压缩注意力的分数,选出 top-k 个块,拿回原始的完整 KV 来算
压缩发现:块2和块4重要

那就把块2和块4的原始KV拿回来:
K₂ = [k₉, k₁₀, ..., k₁₆]  ← 8个K
K₄ = [k₂₅, k₂₆, ..., k₃₂] ← 8个K

Q₃₂ 和这 16 个 K 算注意力 → 精细的局部信息
选择注意力的输出:只融合了重要块的精细信息(精准,但局部)
3. 🟡 滑窗注意力(Sliding Window Attention)
目的:保证邻近的 token 一定被关注到
做法:取最近的 w 个 KV,直接算注意力
Q₃₂ 只和最近的 8 个 KV 算注意力:
[k₂₅, k₂₆, k₂₇, k₂₈, k₂₉, k₃₀, k₃₁, k₃₂]
为什么需要这个? 因为压缩和选择可能漏掉邻近的关键信息。
比如"他"这个代词,它的指代对象通常就在前几个 token——这种关系不能靠全局扫描来捕捉。
4. 🔴 门控聚合(Gating)
三种注意力都算完了,各得到一个输出向量。怎么合并?
用一个可学习的门控来决定各占多少比例:
g_cmp, g_slc, g_win = Sigmoid(MLP(x₃₂))   ← 三个0~1之间的权重

最终输出 = g_cmp × o_cmp + g_slc × o_slc + g_win × o_win
这就像:
- 读论文时,摘要信息占 30%(压缩)
- 核心章节占 50%(选择)
- 前后文衔接占 20%(滑窗)
而且这个比例是模型自己学出来的,不同 token 会有不同比例。
压缩倍数与复杂度分析
具体数值感受
上下文长度 T = 65536 (64K):
| 注意力类型 | KV 数量 | 来源 |
|---|---|---|
| 压缩注意力 | 128 | T/l = 65536/512 |
| 选择注意力 | 4096 | 8 块 × 512 |
| 滑窗注意力 | 4096 | 窗口大小 w |
| NSA 总计 | 8320 | |
| 标准注意力 | 65536 | 全部 KV |
随序列长度增长的复杂度趋势
| 方案 | 计算复杂度 | T 翻倍时 |
|---|---|---|
| 标准注意力 | O(T²) | 计算量 ×4 |
| NSA | ≈ O(T·B_c + T·k·l + T·w) | 计算量 ≈ ×2 |
- B_c(压缩块数)= T/l → 线性增长
- k(选择块数)= 固定常数
- w(滑窗大小)= 固定常数
T → ∞ 时,NSA 的计算量趋近线性增长,标准注意力是二次方增长。T 越大,NSA 优势越明显。
稀疏化导致信息丢失吗?
缓解机制 1:多层叠加覆盖
第 1 层 NSA:选中 [块1, 块3]
第 2 层 NSA:选中 [块2, 块3]
第 3 层 NSA:选中 [块1, 块4]

→ 3 层后,4 个块全部被覆盖
缓解机制 2:信息逐层传播
第 1 层:Q₃₂ 融合了块1和块3的信息 → 输出 o₃₂
                │
                ↓ 残差连接 + FFN
第 2 层:o₃₂ 变成第 2 层的 K₃₂, V₃₂

所以第 2 层的 K₃₂ 已经"知道"块1和块3的内容!
即使第 2 层只选了块2,通过 K₃₂ 也能间接获取块1的信息。
与 MLA / GQA 的关系
| 方案 | 作用位置 | 解决的问题 | 机制 |
|---|---|---|---|
| MLA | Wk/Wv 投影层 | KV-Cache 存储太大 | 低秩压缩 KV 投影 |
| GQA | 注意力头结构 | KV 头数太多 | 多头 Q 共享单头 KV |
| NSA | 注意力计算层 | 注意力计算量太大 | KV 序列稀疏化 |
┌─────────────────────────────────────────┐
│  输入 token x                            │
│         │                                │
│  ┌─── 投影层 ───┐                        │
│  │  Wq, Wk, Wv   │ ← MLA 在这里          │
│  │  (低秩压缩KV)  │   减少KV存储体积       │
│  └───────────────┘                        │
│         ↓ Q, K, V                         │
│  ┌─── 头结构 ───┐                        │
│  │  MHA/GQA/MQA  │ ← GQA 在这里          │
│  │  (多头Q共享KV) │   减少KV头数           │
│  └───────────────┘                        │
│         ↓ 分头后的 Q, K, V                │
│  ┌─── 注意力计算 ─┐                      │
│  │  标准注意力/NSA  │ ← NSA 在这里        │
│  │  (筛选KV再计算)  │   减少参与计算的KV数  │
│  └─────────────────┘                     │
└─────────────────────────────────────────┘

三者可叠加:MLA + GQA + NSA = 低存储 + 低头数 + 低计算
DeepSeek Sparse Attention (DSA)
1. 为什么会有 DSA
- NSA 的痛点是Block-wise(分块)和Native(原生预训练):
- Block-wise(分块)粒度太粗:NSA 采用分块筛选 KV 的策略,但注意力机制在长文本中的注意力分布往往是散落的、细粒度的(Element-wise)。强行分块会导致精度受损,或者为了保精度不得不保留过大的块,降低了稀疏效率
- Native(原生预训练)无法兼容已有的强力基准: NSA 要求模型从零开始进行“原生预训练”。然而,DeepSeek 此时已经拥有了极为强大的
V3.1-Terminus密集(Dense)大模型基座。如果为了稀疏化而放弃成熟的基座从头训练,算力成本和风险都极高
2. DSA核心架构设计
DSA 的本质是:在进入昂贵的标准注意力计算前,先用极低的成本,帮每个 Query Token 筛选出全序列中最有价值的 Top-K(常数,如 2048 个) 个 KV Token。
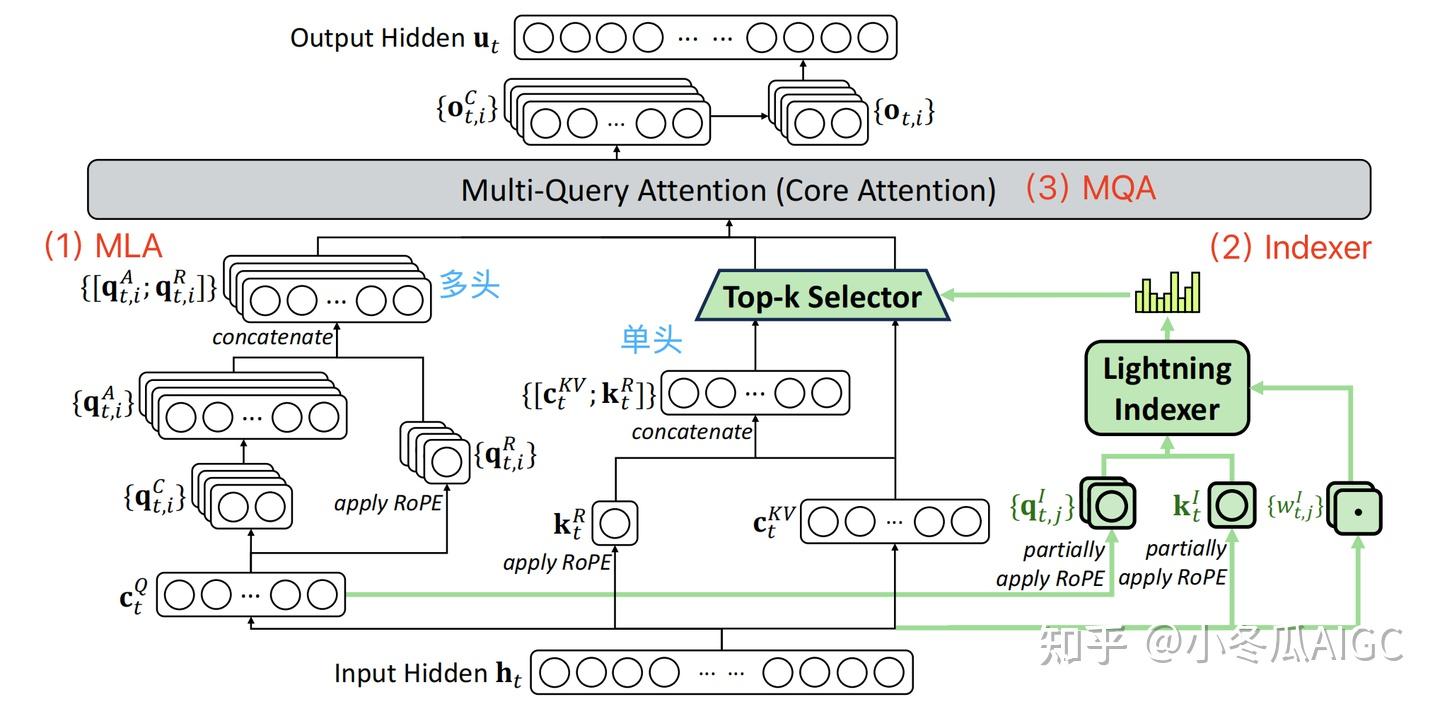
① Lightning Indexer(轻量级索引网络)
计算公式:
低成本筛选: Indexer 拥有独立的投影矩阵。它将主模型的 Latent 放大成多头的 (共 64 个头),而将输入 投影成一个所有头共享的单头 (MQA 的降维思想)。
非线性门控: 利用 学习每个头的重要性权重,并通过
ReLU激活(而不是标准的 Softmax)。整个 Indexer 的计算量仅为主模型 MLA 的约 1/9。最终通过Top-K操作,直接捞出 2048 个细粒度的历史 Token 索引。
② MQA(Multi-Query Attention)的等价变换
为什么要 MQA? 即使选出了 2048 个 Token,如果在从 HBM(显存)向 SRAM(高速缓存)读取 KV Cache 时,依然要恢复成常规的多头(如 128 个头)维度,依然会造成巨大的访存瓶颈。
等价变换: 利用 MLA(Multi-head Latent Attention)本就拥有低秩压缩矩阵的特性,主模型在 Prefill(阶段)采用 MHA 保证计算并行度,但在 Decoding(阶段)可以通过矩阵乘法的结合律,将其优雅地变换为 MQA 机制。
结果: KV Cache 在载入 SRAM 时数据量直接暴降(128 个头变成 1 个头,数据量变为 1/128)。MQA 减小了访存数据量,而 DSA 减小了计算量,两者双剑合璧。
③ Token-wise Mask(细粒度掩码控制)
在工程实现上,DSA 并不是真的去动态裁剪矩阵,因为非对齐的矩阵乘法在 GPU 里极难优化。
- DSA 的做法是:Indexer 选出 Top-K 索引后,生成一个矩阵大小的
index_mask。 - 将未被选中的位置赋值为 (负无穷),被选中的位置赋值为 。
- 将该 Mask 直接叠加到 Attention Score 上进行
Softmax,从而在数学上隐式地抹去非 Top-K 的 Token。配合底层的 Triton/CUDA Kernel 优化,跳过 位置的计算。
3. DSA训练平滑承接 Dense 基座
1. Dense Warm-up 密集预热阶段
- 策略: 冻结主模型,仅训练 Lightning Indexer 1000 步。主模型依然走传统的全量 Dense Attention。
- 目的:让新初始化的 Indexer 去学习和对齐主模型的注意力分布。
- 训练信号来源:KL 散度 Loss,将主模型全量 Attention 分数作为 Target,让 Indexer 的输出去逼近它。
2. Sparse Training 稀疏训练阶段
- 策略: 放开所有参数(主模型+Indexer),正式引入 Top-K 细粒度筛选,只计算稀疏注意力。
- 目的:让主模型和 Indexer 一起适应“只能看到 2048 个 Token”的稀疏新常态。
- 训练信号来源:联合 Loss, Indexer 继续通过局部被选中的 Token 的 KL 散度进行对齐;主模型则专心优化语言建模的 Cross-Entropy Loss。
Ref “乘法结合律”的变换
在普通的 MHA注意力分数(Attention Score)的公式是:
- 是多头的(维度是
[1, 128, 576]) - 也是多头的(维度是
[Len, 128, 576]) - 为了算它,你必须在 Decode 时把这个大矩阵 从显存里拉出来。
DeepSeek 的 MLA引入了一个低秩压缩(Low-rank Compression)的概念。DeepSeek 在生成 的时候,不是直接生成的,而是通过一个低秩压缩向量 (所有头共享的单头向量,维度极小)乘上一个升维矩阵 得到的:
所以,原本的计算公式 就可以写成:
现在,乘法结合律登场了!
- 思路 A(按原样算): 先让 恢复成多头的 。这就是 MHA 模式。
代价: 如果在 Decode 阶段这么干,得在显存里把每一个历史 Token 的多头 都存下来或者恢复出来,数据量暴增 128 倍,显存带宽直接炸掉。
- 思路 B(利用结合律): 既然公式是 ,由于在 Decode 时,当前时刻的 只有 1 个(是已知的),那我们为什么不让 先和 相乘呢?
- 我们在进入注意力计算前,先把当下的 和升维矩阵 乘好,融合成一个临时的中间变量 。
- 接下来,我们只需要去显存里读取那个单头的压缩向量 就可以了!
- 计算变成了:。
Compressed Sparse Attention (CSA)
出处:DeepSeek-V4(2026年4月) 核心思想:先沿序列维度压缩 KV Cache(每 m 个 token 压成 1 个条目),再在压缩后的条目上做 DSA 式的稀疏选择
1. 动机:从"不减存储"到"压缩存储"
DSA 解决了"读多少"的问题,但没解决"存多少"的问题。在百万 token 上下文中,即使不读,光是存储百万条 KV 条目就占用了巨量显存。
CSA 的核心洞察:沿着序列维度(而非 head 维度)压缩。MLA 已经压缩了 head 维度(KV 低秩投影),但序列维度还在线性增长。CSA 直接攻击这个增长根源。
2. Token-Level Compressor(token 级压缩器)
第一步:将每 m 个连续 token 的隐状态压缩为一个 KV 条目。
以 V4-Pro 的配置 m=4 为例:
原始 token 序列:  [h₀, h₁, h₂, h₃, h₄, h₅, h₆, h₇, ...]
分组:             |——— block 0 ———|  |——— block 1 ———|
压缩后:           [C₀,             C₁,             ...]
压缩公式——对每个 block (覆盖 token 到 ):
投影:将每个 token 的隐状态 投影为压缩候选 :
计算权重:生成每个位置的数据依赖权重 (不是简单平均!是可学习的加权):
加权求和:
关键设计——数据依赖的加权:不是简单的平均池化或最大池化,而是让模型学习每个维度保留什么信息。重要的特征在压缩中存活,不重要的被平滑掉。
输入: 4 个 token 的隐状态 (高维, 如 7168维)
       h₀("苹果")  h₁("发布")  h₂("了")  h₃("新")
          ↓            ↓          ↓         ↓
     ┌─────────────────────────────────────────────┐
     │  Step 1: 投影 W_c  (7168 → 4)               │
     │  c₀=[2,0.1,-1.5,3]  c₁=[0.3,4.2,0.8,-0.5] │
     │  c₂=[0,0,0,0]       c₃=[-1,0.5,2.5,1]      │
     └─────────────────────────────────────────────┘
          ↓            ↓          ↓         ↓
     ┌─────────────────────────────────────────────┐
     │  Step 2: 投影 W_s → softmax(沿j轴)          │
     │  每个维度独立选择"最重要的token"              │
     │  d=0: 苹果0.83  发布0.05  了0.002  新0.11   │
     │  d=1: 苹果0.03  发布0.94  了0.006  新0.02   │
     │  d=2: 苹果0.02  发布0.12  了0.006  新0.86   │
     │  d=3: 苹果0.77  发布0.01  了0.04   新0.17   │
     └─────────────────────────────────────────────┘
          ↓
     ┌─────────────────────────────────────────────┐
     │  Step 3: 逐维度加权求和                      │
     │  C₀[0] = 0.83·2 + 0.05·0.3 + ... = 1.565   │
     │  C₀[1] = 0.03·0.1 + 0.94·4.2 + ... = 3.961 │
     │  C₀[2] = 0.02·(-1.5) + 0.86·2.5 + ... = 2.216│
     │  C₀[3] = 0.77·3 + 0.17·1 + ... = 2.475      │
     └─────────────────────────────────────────────┘
          ↓
     输出: C₀ = [1.565, 3.961, 2.216, 2.475]  ← 1个压缩条目,编织了4个token的关键信息
3. 重叠窗口(Overlapping Windows)
CSA 有一个独特设计:每个压缩条目覆盖 2m 个位置(而非 m 个),相邻块之间有 m 个 token 的重叠:
token:    [h₀ h₁ h₂ h₃ h₄ h₅ h₆ h₇ h₈ h₉ ...]
CSA C₀:   [==覆盖 h₀~h₃==]
CSA C₁:          [==覆盖 h₂~h₅==]    ← 与 C₀ 重叠 h₂,h₃
CSA C₂:                [==覆盖 h₄~h₇==]  ← 与 C₁ 重叠 h₄,h₅
为什么重叠?
- 避免在块边界处出现信息硬截断——一个横跨块边界的语义信息不会因为恰好被分到两个块而丢失
- 信息流更平滑,相邻压缩条目之间有过渡
- 相当于"模糊"了量化边界
4. Lightning Indexer + Top-k 选择(继承 DSA)
压缩后,序列长度从 L 降为 L/m。在这个压缩序列上,CSA 使用与 DSA 相同的 Lightning Indexer 机制:
- Lightning Indexer 对 query token 与每个压缩条目 计算索引分数
- Top-k 选择:选取最相关的 k 个压缩条目(V4-Pro 默认约 k=1024)
- V4 中 indexer 从 FP8 进一步降至 FP4 (MXFP4),配合量化感知训练保持精度
压缩序列:  [C₀, C₁, C₂, ..., C_{L/m-1}]     (L/m ≈ 250K 个条目 for 1M context, m=4)
                              ↓
           Lightning Indexer (FP4) 打分
                              ↓
           Top-k=1024 选择
                              ↓
           仅对 1024 个压缩条目做完整注意力
5. 滑动窗口分支
CSA(和 HCA)都包含一个滑动窗口注意力分支,覆盖最近的 个 token,确保局部依赖(如相邻 token 间的语法关系)不被压缩丢失:
6. CSA 的效果
| 指标 | 原始 | CSA 后 (m=4) |
|---|---|---|
| KV Cache 条目数 | L | L/4 |
| 每个 query 读取的条目数 | L | k (如 1024) |
| 存储压缩比 | 1× | 4× |
| 计算压缩比 | 1× | ~L/4k × |
Heavily Compressed Attention (HCA)
出处:DeepSeek-V4(2026年4月) 核心思想:极度压缩(每 m'≫m 个 token 压成 1 个条目),然后在极小的压缩序列上做全量 dense 注意力
1. 设计哲学
如果说 CSA 是"精确保留重要细节的放大镜",那么 HCA 就是"鸟瞰全局的广角镜"。
HCA 追求的不是精确,而是全局覆盖——用最小的计算代价,让每个 query 都能"看到"整个上下文的大致轮廓。
2. 与 CSA 的对比
| 维度 | CSA | HCA |
|---|---|---|
| 压缩比 | m = 4 (4个→1个) | m' = 128 (128个→1个) |
| 重叠 | 有 (2m 覆盖,m 重叠) | 无 (不重叠,紧密分组) |
| 稀疏选择 | 有 (Lightning Indexer + Top-k) | 无 (dense 注意力) |
| KV 流 | 两条(重叠产生双流) | 一条 |
| 注意力方式 | 稀疏(只看 top-k 压缩条目) | 全量(看所有压缩条目) |
| 角色 | 精确稀疏检索 | 全局粗粒度概览 |
| 1M context 后条目数 | ~250K | ~8K |
3. 压缩机制
HCA 的压缩公式与 CSA 共享同一核心方程,但参数更激进:
1M token 序列, m'=128:
  [h₀ h₁ ... h₁₂₇] [h₁₂₈ ... h₂₅₅] ... [h_{L-128} ... h_{L-1}]
        ↓                   ↓                      ↓
      C₀                  C₁               ...  C_{7812}
- 1,000,000 / 128 ≈ 7,812 个压缩条目
- 这个数量小到可以对全部条目做 dense softmax 注意力,无需稀疏选择
4. 为什么 HCA 不需要稀疏选择?
在 1M context 下:
- CSA:~250K 个压缩条目 → 仍然太多,无法全量注意力 → 需要 Top-k
- HCA:~8K 个压缩条目 → 直接 dense 注意力的计算量完全可接受
8K 个条目的 dense 注意力,计算量约为 8K × 512(压缩维度)≈ 4M FLOPs/query,极其廉价。
5. HCA 的信息损失与补偿
128:1 的压缩不可避免地丢失细节信息。但这没关系——HCA 的目标是:
- 捕捉全局主题/结构:文档大致讲了什么、论点如何展开
- 作为"索引":帮助后续 CSA 层定位"应该仔细看哪里"
- 不承担精确生成任务:最终 token 生成由 CSA 和全量注意力层负责
6. V4 中的混合分层策略
DeepSeek-V4 不是全局使用同一种注意力,而是逐层交替使用:
┌──────────────────────────────────────────────────────┐
│  Layer 1 (浅层):  HCA  ← 全局鸟瞰,建立上下文骨架    │
│  Layer 2:         HCA                                │
│  Layer 3:         CSA  ← 精确检索,定位重要区域       │
│  Layer 4:         HCA                                │
│  Layer 5:         CSA                                │
│  ...               ... (CSA 与 HCA 交替)              │
│  最终层 (深层):   全量注意力 ← 最高精度,无损生成    │
└──────────────────────────────────────────────────────┘
设计直觉:
- 浅层需要快速建立全局理解 → HCA(全局概览,计算便宜)
- 中层需要兼顾全局和细节 → CSA + HCA 交替
- 深层/最终层需要最高精度 → 全量无损注意力(只在最后一层,代价可控)
类比人类阅读:
- 先快速浏览目录和标题(HCA)
- 定位到感兴趣的章节,精读关键段落(CSA)
- 在关键段落上一字一句理解(全量注意力)
Qwen Sparse Attention (QSA)
出处:Qwen3.8-Flash-Next(2026年8月,Qwen4 架构的早期预览) 参考:Sebastian Raschka 图解 | Qwen 官方 Blog
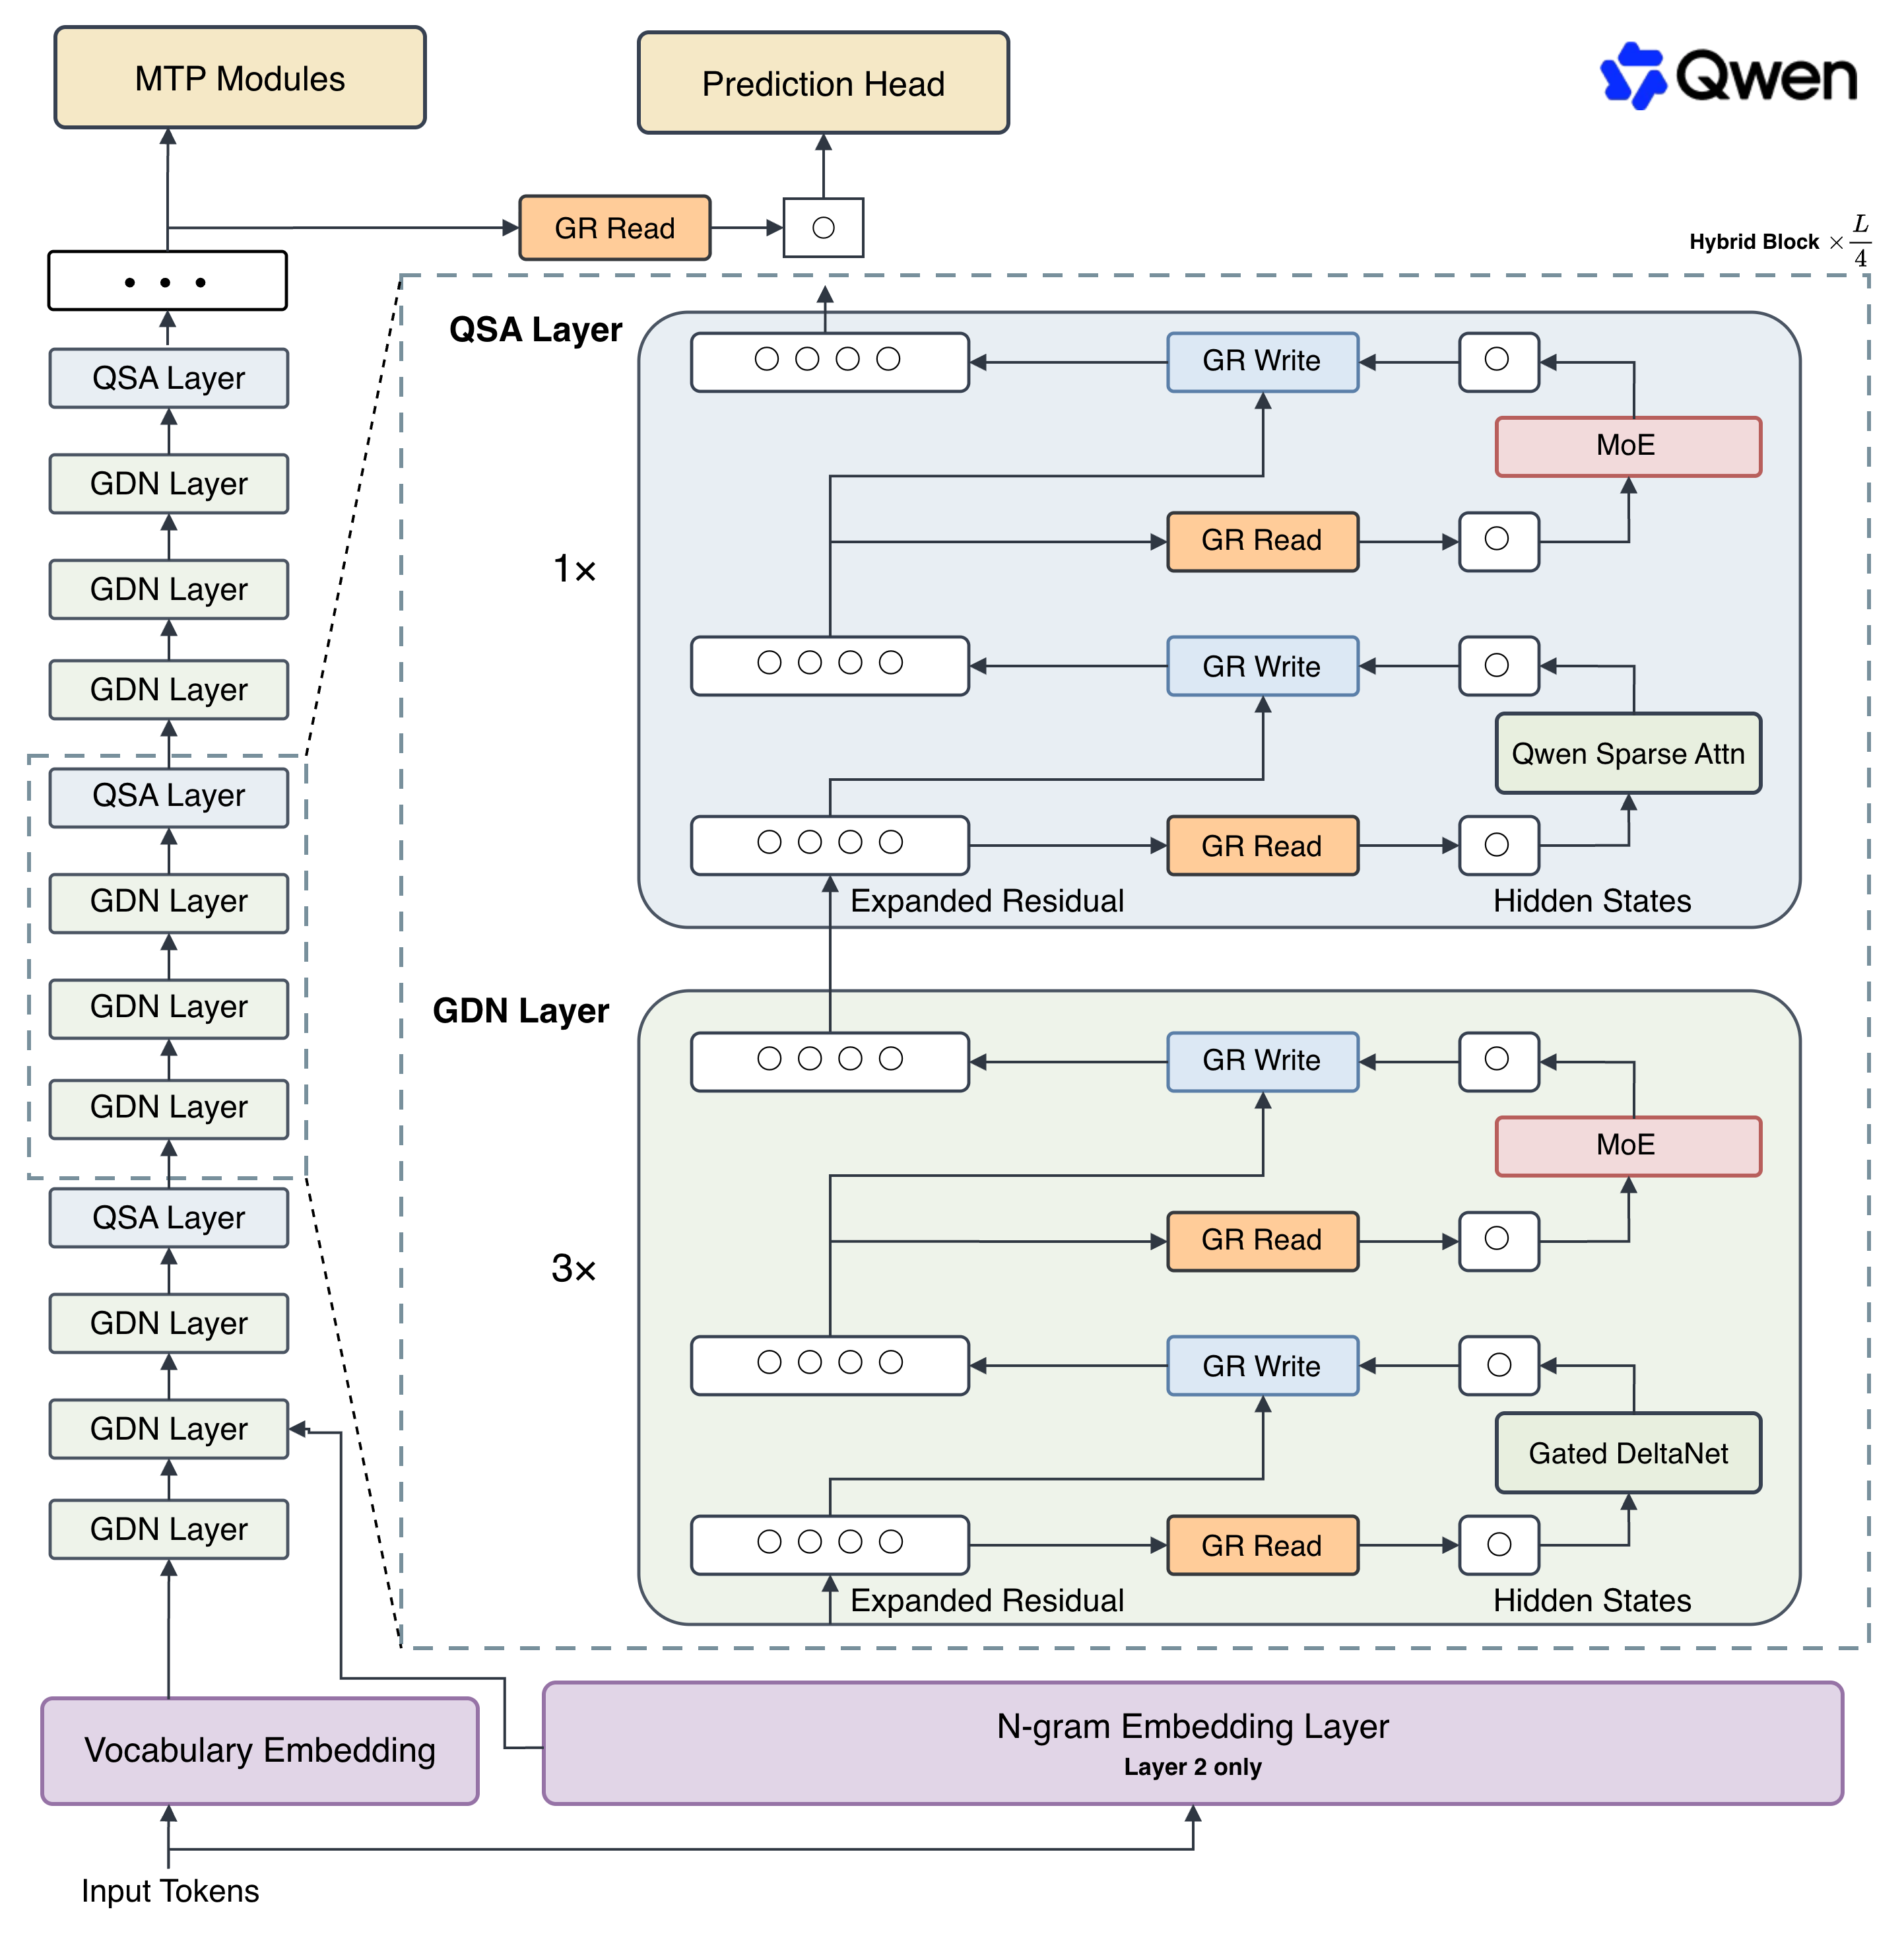
核心思想:继承 DSA 的"轻量级索引器 + Top-K 筛选"范式,但将筛选单位从 token 提升为 4-token 微块(Micro-block)——先在块级粗筛出 Top-512 块,再无损展开回 token,从原始 KV Cache 中取全精度 K/V,对 ~2K 常数级候选集做标准稀疏 GQA 精算。索引开销降为 DSA 的 1/4,最终注意力零精度损失。
一句话概括 QSA
QSA = 块级粗筛(轻量 Indexer,Top-512 微块)→ 无损展开(+ 尾部未完成块强制拼接)→ 从原始 Cache 取全精度 KV → 常数级候选集上跑标准 GQA。压缩块键自始至终只是"路标(Index)",绝不参与最终注意力计算。
1. 为什么会有 QSA
- DSA 的痛点是 Token-level 索引太贵:
- Lightning Indexer 需要对每个可见 token 逐一打分排序,上下文增长到百万级后,索引器自身的线性扫描量成为不可忽视的开销
- IndexCache 等跨层共享索引的方案,赌的是"相邻层注意力分布相似",但在 GDN 线性层与 Attention 层交错的混合架构中,两类层的注意力分布差异很大,该假设不成立
- QSA 的解法(两点):
- 以"4-token 微块"为筛选单位:打分对象从 个 token 变为 个块,索引开销直接 ÷4
- 每层独立压缩、独立选块:不依赖跨层注意力相似性,天然适配 GDN + Attention 交错架构
2. QSA 在模型中的位置(GDN + QSA 混合架构)
GDN 高效地"记",QSA 精确地"找"。
- Qwen3.8-Flash-Next 共 48 层,按 3:1 排布:
- 36 层:Gated DeltaNet(线性注意力,维护固定大小状态矩阵,不产生增长型 KV Cache)
- 12 层:QSA(唯一产生增长型 KV Cache 的层)
- MTP(多 token 预测)模块中的全注意力层也一并被 QSA 替换
- 上下文:原生 262,144 tokens,YaRN 外推至 1,000,000
┌───────────────────────────────────────────┐
│  Layer 1  (GDN)   固定状态 S,无 KV 增长   │
│  Layer 2  (GDN)                                │
│  Layer 3  (GDN)                                │
│  Layer 4  (QSA)   ★ 增长型 KV Cache + 块级筛选 │
│  ...        每 4 层重复一次 ...               │
│  Layer 48 (QSA)                                │
└───────────────────────────────────────────┘
        36 层 GDN : 12 层 QSA = 3 : 1
3. QSA 核心架构设计
QSA 的本质:轻量级索引器通过"块级粗筛"选出 Top- 个微块后,不直接拿压缩块键去算最终注意力,而是经历"还原 → 组装 → 精算"的精密流程。
总览图
可见前缀 (最多 1M tokens)
        │
        ▼
┌──────────────────────────────┐
│ ① 轻量级索引器 (Indexer)      │
│  - 每 4 token 分成一个微块     │
│  - 块内 K 均值 → 归一化        │
│  - RoPE (用块首位置)          │
│  - 多头 ReLU 打分, 取 Top-512 │
└──────────────────────────────┘
        │  512 个块编号 (仅是"路标", 不是数据)
        ▼
┌──────────────────────────────┐
│ ② 展开 + 拼尾部 (Expand)      │
│  - 512 块 → 2048 个 token 索引 │
│  - 无条件拼当前未完成块 (0~3)  │
└──────────────────────────────┘
        │  稀疏候选集 S_i (≤ 2051 tokens)
        ▼
┌──────────────────────────────┐
│ ③ 从原始 KV Cache 取全精度 K/V │
│  (vLLM/SGLang 按索引精准提取) │
└──────────────────────────────┘
        │
        ▼
┌──────────────────────────────┐
│ ④ 标准稀疏 GQA 精算           │
│  Softmax(Q·K_sparseᵀ/√d_k)   │
│  → 加权聚合 V_sparse          │
└──────────────────────────────┘
① 轻量级索引器:块级粗筛
把可见前缀按 4 个 token 分组,每个完整微块压缩成一个"块键",再与当前 Query 打分:
complete_blocks = group(visible_prefix, block_size=4)    # 每 4 个 token 一块
block_keys      = mean(keys in each complete block)       # 块内 K 均值池化
# → 归一化 → RoPE(块首位置)
scores          = sum(relu(query_head @ block_key)        # 多索引头打分求和
                      for each indexer head)
selected_blocks = top_k(scores, k=512)                    # 选出 512 个块
attention_input = flatten(selected_blocks)                # 展开回 token 位置
                  + current_incomplete_block              # + 尾部未完成块
- 打分公式沿用 DSA Lightning Indexer 的 ReLU 多头思想(不用 Softmax),但作用对象从 个 token 变为 个块
- RoPE 使用块内首个 token 的位置:均值池化抹掉了位置信息,用块首位置给块键注入"这一整块在时间轴上大致在哪"的粗粒度位置信号
- 预算换算:2048 token 预算 ÷ 4 token/块 = 最多 512 个完整块
- 块键仅用于打分:压缩在这里是"有损"的,但它只是路标,不进入最终注意力
原始 K 序列(可见前缀,百万级):
[k₁ k₂ k₃ k₄ | k₅ k₆ k₇ k₈ | ... | kₘ kₘ₊₁]
  └─ 块1 ─┘    └─ 块2 ─┘           └ 尾部块(不满4)
      ↓ 均值池化       ↓
  [ k̃₁ ]         [ k̃₂ ]   ...     (尾部块不池化, 无条件保留)
      ↓ RoPE(块首位置)
      ↓
  与 Query 打分 → Top-512 块
② 索引展开与尾部拼装(Expand & Assembly)
- Token 级还原:512 个块编号**无损展开(Unpack)**回 2048 个高精度 token 位置索引
- 尾部强制拼接(Tail Integration):最后一个微块往往不满(含 0~3 个 token),这些是离当前 Query 最近的信息(局部语法、连贯性依赖),不能因所在块没进 Top-512 而漏掉 → 无条件拼入,同时保证因果掩码完整
- 最终候选集: 个 token,远小于百万级全量上下文
512 个块编号 ──Expand──→ 2048 个 token 索引
                              │
                              +  尾部未完成块 (0~3 个, 无条件拼入)
                              │
                              ▼
                        S_i ≤ 2051 个位置
对比 DSA:DSA 对 token 独立排序,没有也不需要块尾规则——这是"选块"vs"选 token"的直接差异之一。
③ 从原始 KV Cache 提取全精度数据
- 关键点:被压缩的块键仅充当"路标",自始至终不参与最终注意力
- 显存中始终保存完整的、未压缩的 K/V Cache(QSA 压的是计算与索引,不压存储内容——区别于 CSA/HCA)
- 确定 ~2K 个位置后,推理引擎(vLLM/SGLang)按索引从 HBM 精准提取对应 token 的完整 、
- 每 query 的 KV 读取量被限制在常数 ~2K,访存瓶颈同步缓解
④ 执行标准稀疏注意力计算(Sparse GQA)
拿到 ~2K 个全精度 K/V 后,在候选集上跑完全标准的 GQA 矩阵运算(QSA 层内部采用 GQA 头结构):
1. 注意力得分(Softmax):
Softmax 只在 ~2051 个位置上归一化——注意力权重在精选集合内重新竞争,被丢弃的 token 权重严格为 0
2. 加权聚合 Value:
由于 、 是原始全精度向量,选中的 token 上不存在任何近似误差;精度损失只可能来自"选错了块"(块级粗筛的代价,见 §5)
4. 复杂度分析(1M 上下文、单 Query 视角)
| 环节 | 标准注意力 | DSA (token 级) | QSA (块级) |
|---|---|---|---|
| 索引打分 | — | ||
| 注意力计算 | |||
| KV 读取量 | 全部 | 2048 个 token | 2048~2051 个 token |
| KV 存储 | (不压存储) | (不压存储) |
- 注意力主体成本:QSA 与 DSA 持平(都是常数级)
- 索引成本:QSA 是 DSA 的 1/4, 越大相对优势越明显
- 叠加混合架构红利:KV Cache 只有 12/48 层在增长(GDN 层只维护固定状态),存储层数天然省 4 倍
实测效果(Qwen 官方):
| 指标 | 数值 |
|---|---|
| 1M 上下文 Attention Kernel 加速 | Prefill 7.6× / Decode 4.9× |
| 90% Prefix Cache 命中场景 | Prefill 吞吐达 Qwen3.7-Plus 的 8.6×(1M 上下文) |
5. QSA vs DSA vs NSA
| 方案 | 出处 | 筛选单位 | 粒度 | 2048 预算含义 | 尾部未完成块 | 最终注意力用什么数据 |
|---|---|---|---|---|---|---|
| NSA | DeepSeek | 大块 (512 token/块) | 粗 | top-k 个块 | 由滑窗分支兜底 | 选中块的原始 KV |
| DSA | DeepSeek V3.2 | 单个 token | 细 | 最多 2048 个 token | 无对应规则 | 选中 token 的原始 KV |
| QSA | Qwen3.8-Flash-Next | 4-token 微块 | 中 | 最多 512 个块 | 无条件直接包含 | 选中块的原始 KV(+尾部) |
演化逻辑:NSA 大块"粒度过粗,可能误伤一大片" → DSA token 级"精准但索引贵" → QSA 取中间点:4-token 微块,在索引成本与选择精度之间平衡。
QSA 块级选择的代价("误伤"):
- 选中 1 个关键 token,会连带其所在块的另外 3 个(冗余,但候选集内 softmax 会自动压低其权重)
- 漏掉 1 个块,则整块 4 个都看不到(粒度上的理论精度损失)
- Qwen 的判断:4 足够小,误伤有限;索引开销 ÷4 的收益更大
Slide Window Attention (SWA)

SWA: 限制每个 token 的注意力范围
- 单层滑动窗口只能看到局部上下文
- 但多层堆叠后,原理同CNN,信息可通过层间传播实现超窗口范围的依赖
| 注意力类型 | 计算复杂度 | 说明 |
|---|---|---|
| Causal Attetion | 每个 token 需与所有历史 token 计算注意力得分( 个 token × 个历史位置 × 维度) | |
| Slide Window Attetion | 每个 token 仅与窗口内 个 token 计算注意力( = 窗口大小,通常 2048~32768) |
| 注意力类型 | KV Cache 内存 | 说明 |
|---|---|---|
| Causal Attetion | 需缓存全部历史 token 的 Key/Value( = head 数) | |
| Slide Window Attetion | 理论上只需缓存最近 个 token 的 KV |
缺陷Attention Sink
当使用纯滑动窗口推理超长序列时,模型性能会急剧下降。原因:
- 初始 token(如 prompt 开头)逐渐滑出窗口 → 永久丢失
- 这些 token 往往包含关键上下文(如指令、角色设定)
- 模型失去“锚点”,导致生成质量崩塌
修复方案
1. StreamingLLM
保留前 个 token(sink tokens)的 KV Cache,同时对后续 token 使用滑动窗口:
2. 混合注意力
- Method 1: 将滑动窗口(局部)与全局注意力以 1:1 的比例结合使用
- Method 2: 每 5 层局部注意力(滑动窗口)层中只穿插 1 层全局注意力层
Infini-attention
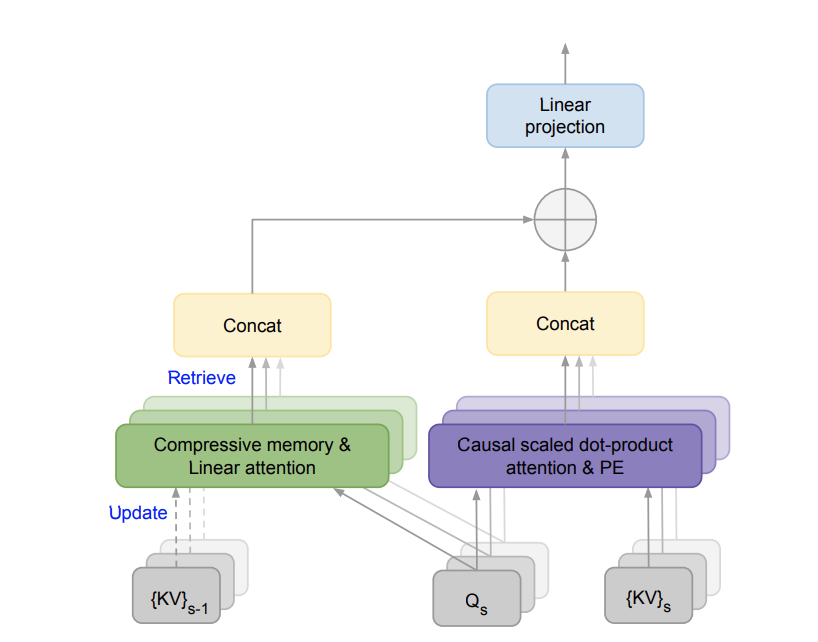
原理
1. 压缩长期记忆 (递归更新)
对第 个 token,压缩记忆 和归一化向量 按以下规则更新:
- :遗忘因子(可学习标量),控制历史记忆衰减速率
- :强遗忘,仅保留近期上下文
- :弱遗忘,长期记忆累积(但需防数值溢出)
- :特征映射核函数,将 Key 映射到线性注意力空间
- 标准选择:(保证非负性,稳定训练)
- 维度固定为 (与序列长度 无关)→ 内存有界性保证
2.长期注意力计算
- 分子 :压缩记忆与当前 Query 的交互
- 分母 :归一化项(避免数值不稳定)
- 计算复杂度:(与 无关)→ 支持无限长序列
3. 局部注意力 & 长期注意力 融合 - 门控机制
局部注意力 与长期注意力 通过 sigmoid 门控融合:
- :可学习标量参数(初始化为 0)
- :完全依赖局部注意力(短上下文场景)
- :完全依赖压缩记忆(超长上下文场景)
- 训练自适应:模型自动学习不同任务/长度下的最优融合比例
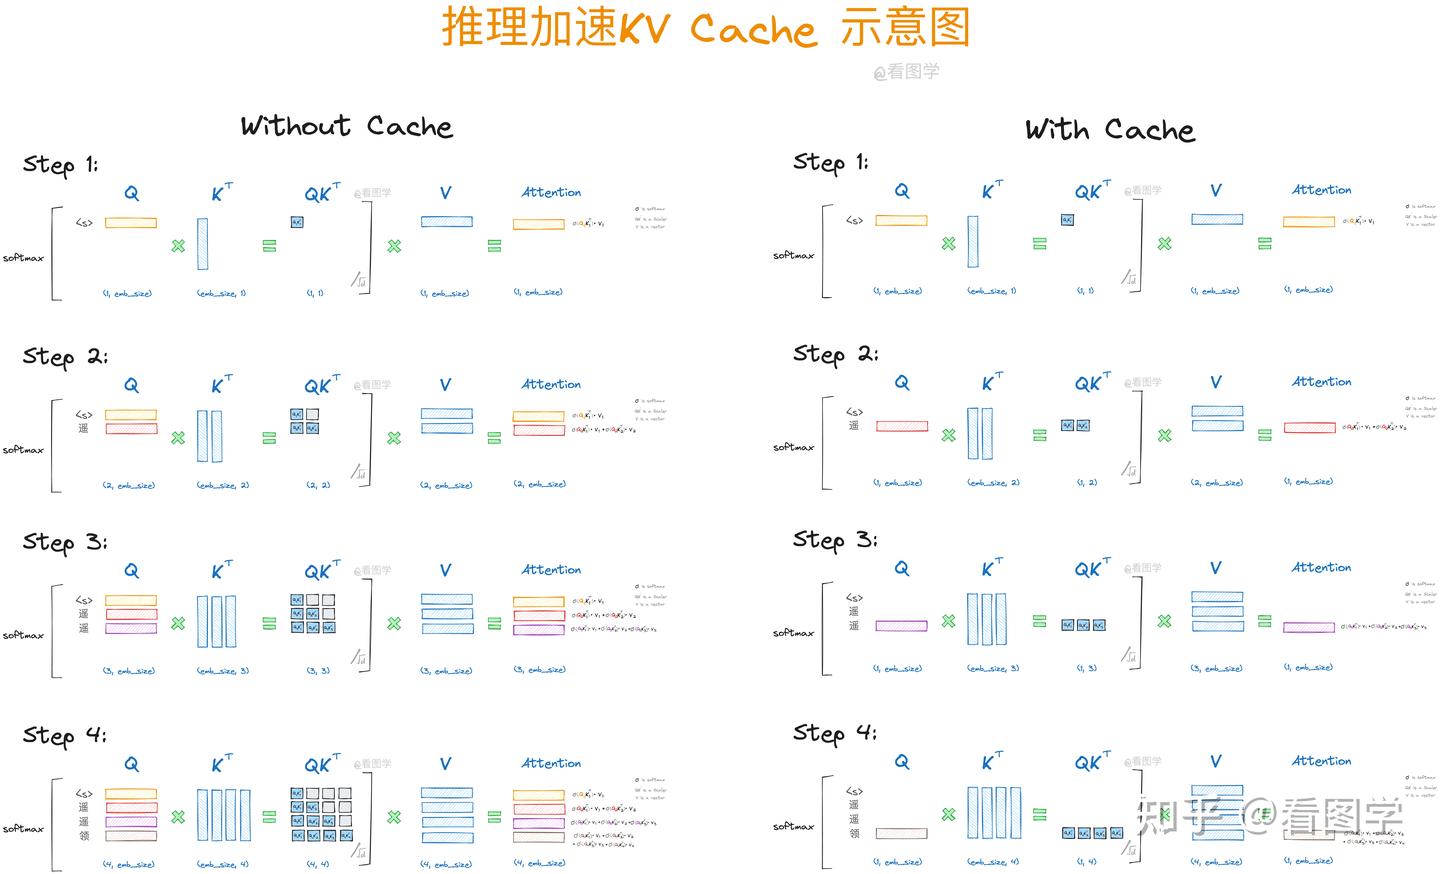
KV Cache
MTP(Multi-Token Prediction)
1. Blockwise Parallel Decoding(Google, NeurIPS 2018)
📄 Blockwise Parallel Decoding for Deep Autoregressive Models 重点:推理加速
网络结构:
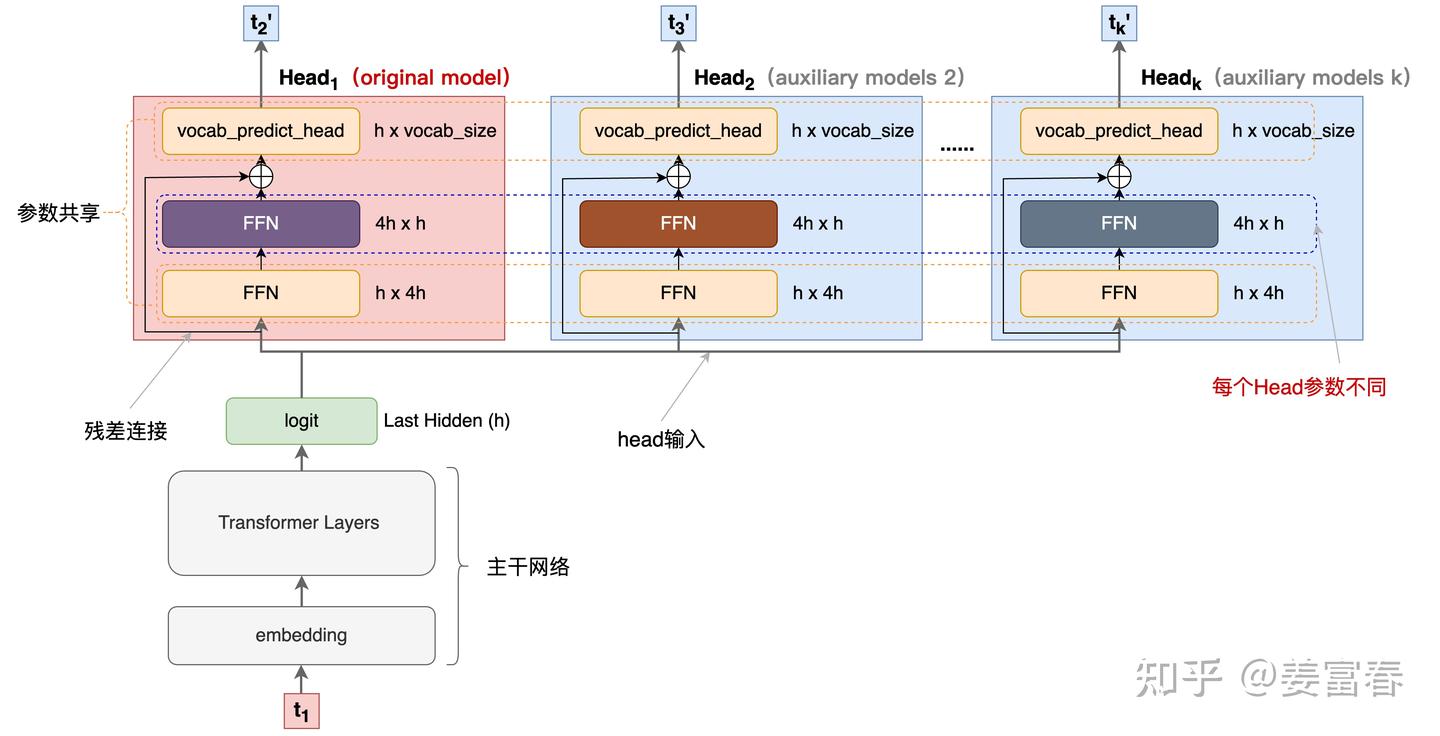
关键结构要点:
| 组件 | 是否共享 |
|---|---|
| 第一层FFN(h→4h) | ✅ 共享 |
| 第二层FFN(4h→h) | ❌ 各Head独立 |
| 词表投影+Softmax | ✅ 共享(原模型的) |
推理三阶段:
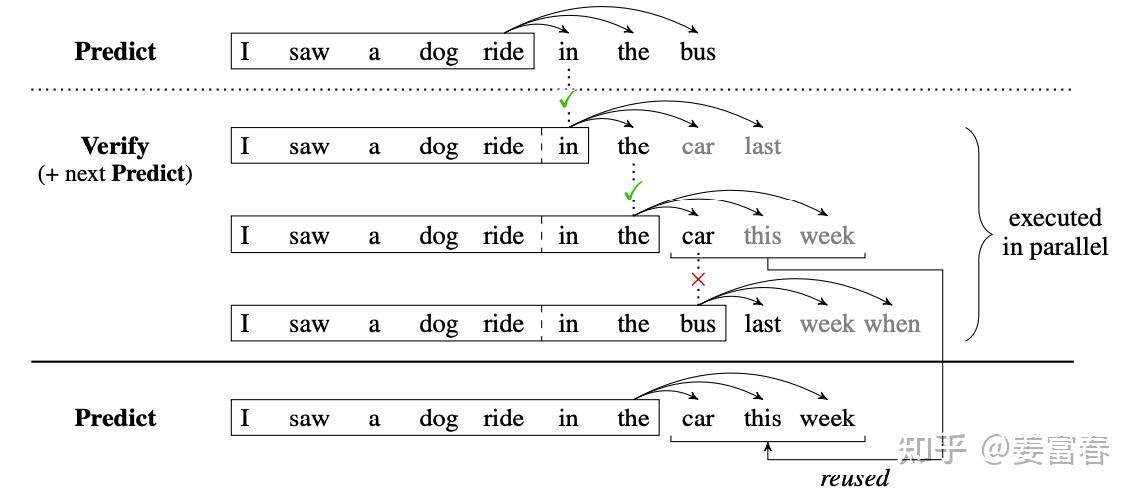
- Predict:k个Head一次生成k个token
- Verify:将序列+生成token拼接为k个
<sequence_input, label>对,组成Batch送Head₁校验 - Accept:取Head₁预估与label一致的最长k个token
加速比分析(假设所有辅助Head预测全部正确):
| 方案 | 推理步数 | k=4时加速比 |
|---|---|---|
| Token-by-token | m | 1× |
| 三阶段不重叠 | 2m/k | 2× |
| Predict与Verify重叠 | 1+m/k | ≈3.2× |
⚡ GPU并行特性使得:单序列vs批序列、单头vs多头计算时间差异可忽略,瓶颈在访存而非计算。
2. Meta's MTP(Meta, 2024.04)
📄 Better & Faster Large Language Models via Multi-token Prediction 重点:训练+推理双优化
网络结构:
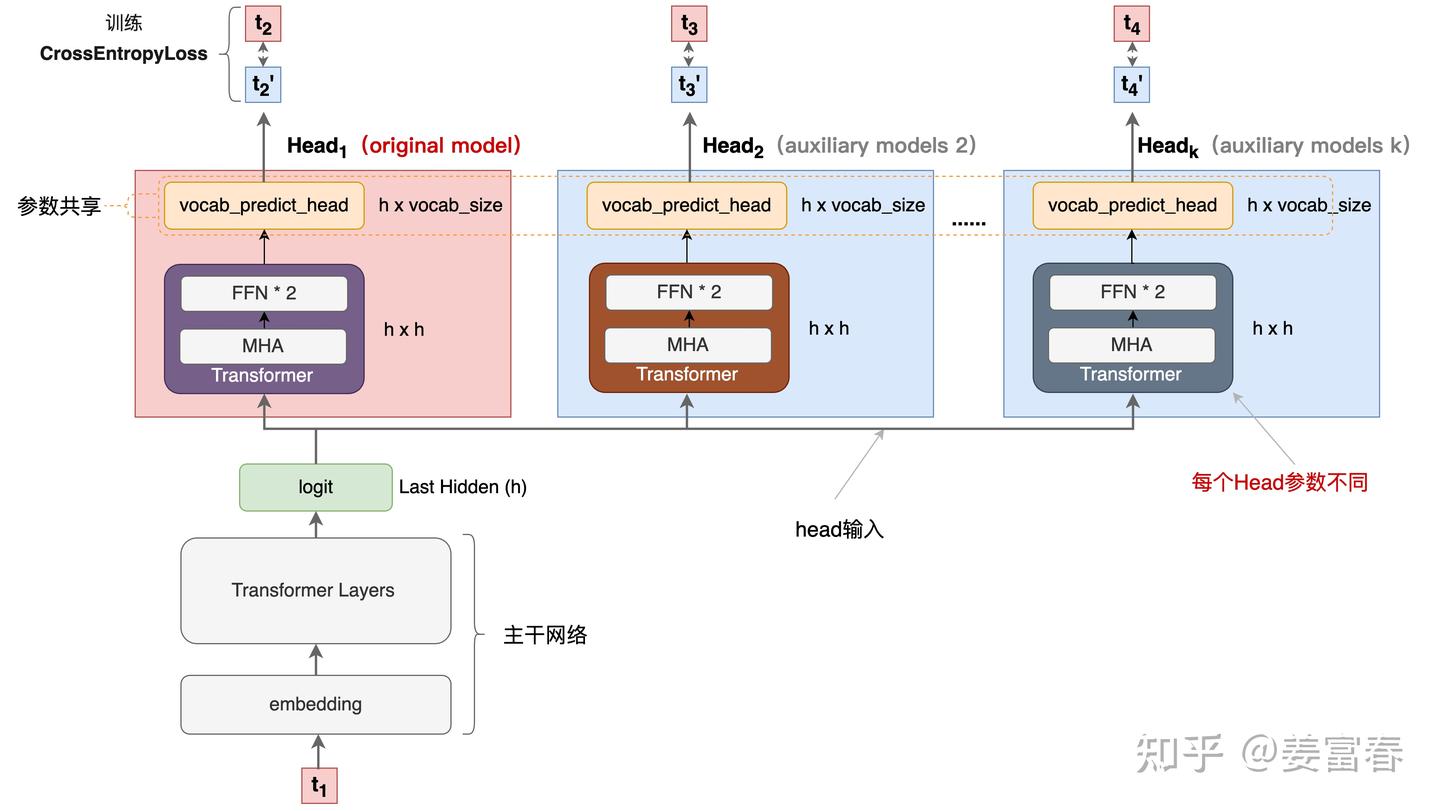
与Blockwise Parallel Decoding的差异(极小):
- Head内部结构:2层FFN → 完整Transformer层(MHA+FFN)
- 新增关注训练加速(多个Head并行计算loss,提升样本利用效率)
⚠️ 关键共性:各Head独立,无信息传递
3. DeepSeek MTP(DeepSeek, 2024.12)
📄 DeepSeek-V3 重点:以训练加速为主,推理为辅
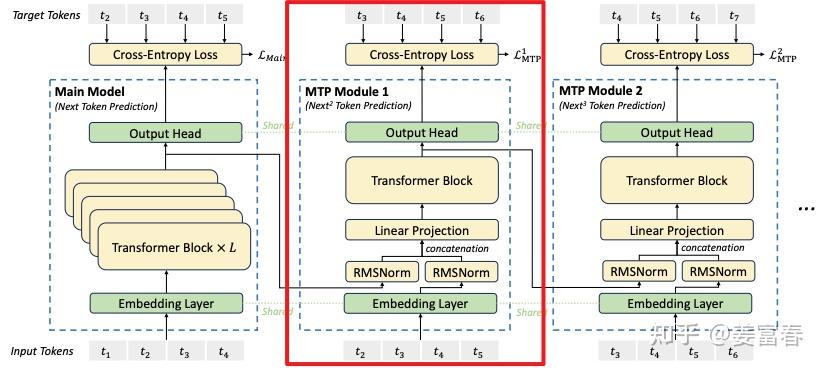
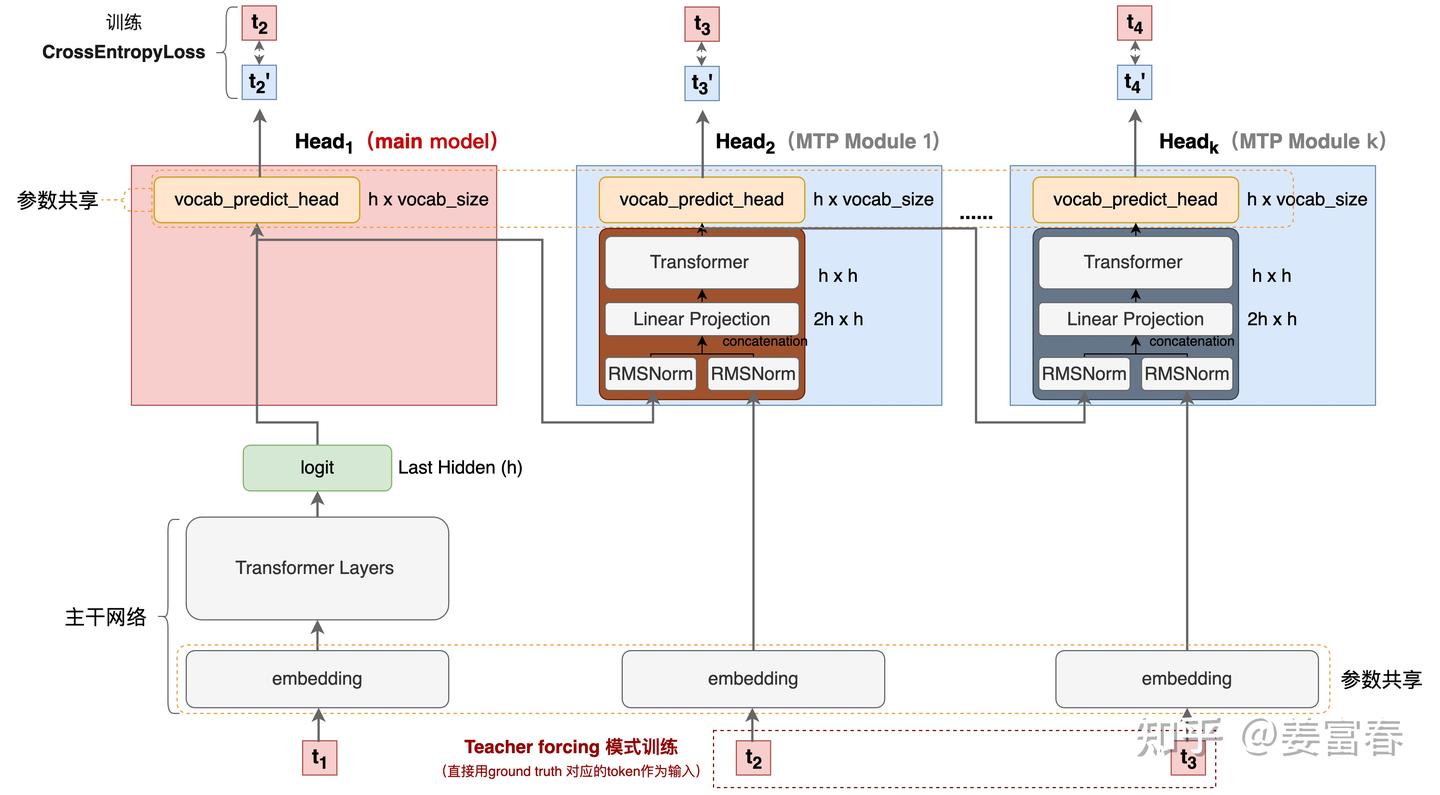
与前面方法最本质的差异:因果链(Causal Chain)连接——各预测Module顺序连接,信息逐步传递
3.1 MTP模块实现
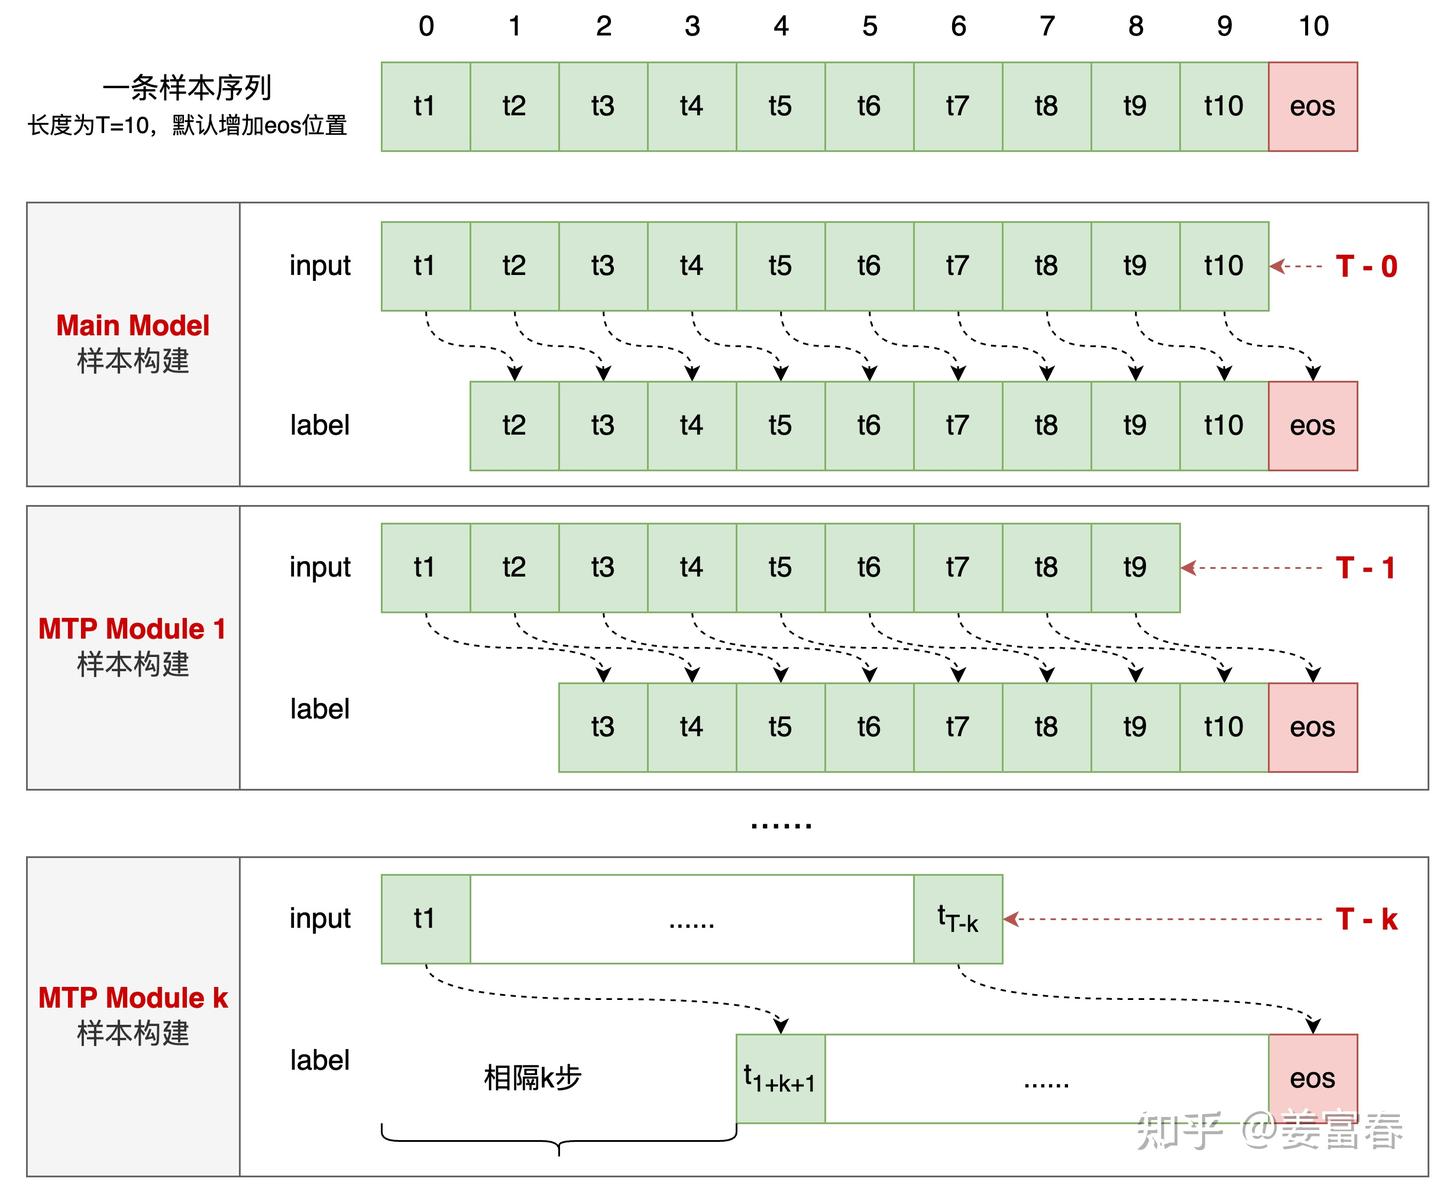
3.2 训练样本构建
3.3. 推理方式
方法1:删除MTP头 → 退化为普通LLM推理,无加速
方法2:Self-Speculative Decoding(类似Blockwise三阶段)
- Predict:k个Module一次生成k个token(Free-Running模式)
- Verify:拼接序列,组Batch送Main Model校验
- Accept:取验证通过的最长token序列
注意:推理时Emb()用的是预测token的embedding,不是ground truth